扩散模型 DDPM
1. 基本思路
DDPM(Denoising Diffusion Probabilistic Models,去噪扩散概率模型) 的想法是:先规定一种逐步破坏图片的方法,再训练网络学习相反方向的变化。训练完成后,从一张随机噪声图出发,重复许多次去噪,就能生成符合训练数据规律的新图片。
将原图记为 \(x_0\),加噪一次后记为 \(x_1\),共加噪 \(T\) 次。两个方向分别是:
\[ \begin{aligned} \text{前向加噪:}&\quad x_0\longrightarrow x_1\longrightarrow\cdots\longrightarrow x_T,\\ \text{反向生成:}&\quad x_T\longrightarrow x_{T-1}\longrightarrow\cdots\longrightarrow x_0. \end{aligned} \]前向过程按预设规则加噪,反向过程由网络学习。加噪会丢失信息,同一张噪声图可能对应多种合理结果,因此模型学习的是如何逐步生成符合数据规律的新图片。
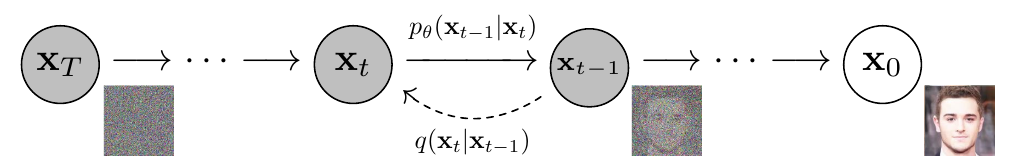
图中从左向右是生成方向,\(x_T\) 在左、\(x_0\) 在右。把图片的像素和颜色通道展开,就可以将 \(x_t\) 看作 \(\mathbb R^D\) 中的向量;例如 \(32\times32\) 的 RGB 图片有 \(D=32\times32\times3\) 个分量。下面的向量公式同时作用于所有分量,初读时也可以先按一个像素理解。
全文用 \(q\) 表示真实数据及预设的加噪分布,用 \(p_\theta\) 表示生成模型,\(\theta\) 是网络中需要学习的参数。离散步数 \(t\) 用来标记当前的噪声程度。
高斯分布与条件分布
一维高斯分布的均值为 \(\mu\)、方差为 \(\sigma^2\),密度为:
\[f(x)=\frac{1}{\sqrt{2\pi\sigma^2}}\exp\!\left(-\frac{(x-\mu)^2}{2\sigma^2}\right).\]向量记号 \(\mathcal N(\mu,\Sigma)\) 中,\(\Sigma\) 是协方差矩阵。\(\mathcal N(0,I)\) 表示各分量相互独立,均值为零、方差为一;\(\mathcal N(\mu,\sigma^2I)\) 则将每个分量的方差统一为 \(\sigma^2\)。
\(q(x_t\mid x_0)\) 表示已知原图后,噪声图像的条件分布。密度描述反复采样时的统计规律,某张具体图片只是一次样本;连续变量的概率需要对密度积分,密度值本身不是取到某个点的概率。
2. 前向过程
2.1 单步加噪
第 \(t\) 步预先选择一个较小的数 \(0<\beta_t<1\),定义 \(\alpha_t=1-\beta_t\),然后进行:
\[ x_t=\sqrt{\alpha_t}\,x_{t-1}+\sqrt{\beta_t}\,\epsilon_t, \qquad \epsilon_t\sim\mathcal N(0,I). \]每一步都重新抽取与已有状态独立的噪声。第一项略微缩小已有图像,第二项加入随机扰动;根号作用在系数上,因此这个式子仍然是线性叠加。由于 \(\beta_t\) 表示新噪声的方差,乘在标准噪声前的系数应是标准差 \(\sqrt{\beta_t}\)。
同一操作也可以写成条件分布:
\[ q(x_t\mid x_{t-1}) =\mathcal N\!\left(x_t;\sqrt{\alpha_t}x_{t-1},\beta_tI\right). \]这里采用马尔可夫链:给定当前状态后,下一步的分布不再需要此前的历史,即 \(q(x_t\mid x_{t-1},\ldots,x_0)=q(x_t\mid x_{t-1})\)。整条加噪路径的条件密度因此是各步密度的乘积。
为什么方差要乘系数的平方
方差衡量变量偏离其平均值的程度,定义为:
\[\operatorname{Var}(X)=\mathbb E\!\left[(X-\mathbb E[X])^2\right].\]将 \(X\) 乘以 \(a\) 后,偏离量也乘以 \(a\),平方后便得到:
\[\operatorname{Var}(aX)=a^2\operatorname{Var}(X).\]对两个变量的线性组合展开平方,有:
\[\operatorname{Var}(aX+bY)=a^2\operatorname{Var}(X)+b^2\operatorname{Var}(Y)+2ab\operatorname{Cov}(X,Y).\]独立变量的协方差为零,因此两个独立标准高斯变量组合后,方差为 \(a^2+b^2\)。
只看一个分量,单步加噪满足:
\[ \operatorname{Var}(x_t^{(i)}) =\alpha_t\operatorname{Var}(x_{t-1}^{(i)})+\beta_t. \]若上一步方差为 \(1\),下一步仍为 \(\alpha_t+\beta_t=1\);其他情况下,新方差是旧方差与 \(1\) 的加权平均。这就是“方差保持”这一设计的含义:在逐步增加噪声的同时控制数值尺度,便于同一个网络处理不同噪声程度的图片。
向量的协方差
向量 \(X\) 的 \(\operatorname{Cov}(X)\) 是矩阵,第 \((i,j)\) 项为 \(\operatorname{Cov}(X^{(i)},X^{(j)})\):对角线记录各分量的方差,非对角线记录不同分量的协方差。对同维向量 \(X,Y\) 和标量 \(a,b\):
\[\operatorname{Cov}(aX+bY)=a^2\operatorname{Cov}(X)+b^2\operatorname{Cov}(Y)+ab(C+C^{\mathsf T}).\]其中 \(C=\operatorname{Cov}(X,Y)=\mathbb E[(X-\mathbb E[X])(Y-\mathbb E[Y])^{\mathsf T}]\),\(C^{\mathsf T}=\operatorname{Cov}(Y,X)\)。若 \(X,Y\) 独立,交叉项为零,只剩前两项。
图片和纯噪声可以有相同的总体方差,而物体轮廓等结构仍会被加噪破坏。将协方差公式用于单步加噪,由于新噪声与原状态独立、协方差为 \(I\),有:
\[ \operatorname{Cov}(x_t)=\alpha_t\operatorname{Cov}(x_{t-1})+\beta_tI. \]对于不同分量 \(i\ne j\),\(I\) 的对应项为零,因此:
\[ \operatorname{Cov}(x_t^{(i)},x_t^{(j)}) =\alpha_t\operatorname{Cov}(x_{t-1}^{(i)},x_{t-1}^{(j)}). \]这种变化作用于整张图片中的像素联系。协方差逐渐减小,最终各分量的近似独立性则来自整个联合分布接近标准高斯。
2.2 累积加噪
训练时需要构造不同噪声程度的图片。如果每次都从头逐步加噪,开销很大,因此先推导从原图直接得到 \(x_t\) 的公式。记累计系数为:
\[ \bar\alpha_t=\prod_{s=1}^{t}\alpha_s, \qquad \bar\alpha_0=1. \]将前两步展开:
\[ \begin{aligned} x_2 &=\sqrt{\alpha_2}\left(\sqrt{\alpha_1}x_0+\sqrt{\beta_1}\epsilon_1\right) +\sqrt{\beta_2}\epsilon_2\\ &=\sqrt{\alpha_1\alpha_2}x_0 +\sqrt{\alpha_2\beta_1}\epsilon_1+\sqrt{\beta_2}\epsilon_2. \end{aligned} \]独立高斯变量的线性组合仍是高斯。两项噪声合并后的方差为 \(\alpha_2\beta_1+\beta_2=1-\alpha_1\alpha_2\),推广到第 \(t\) 步就得到:
\[ \boxed{x_t=\sqrt{\bar\alpha_t}\,x_0+\sqrt{1-\bar\alpha_t}\,\epsilon}, \qquad \epsilon\sim\mathcal N(0,I). \]等价地,
\[ q(x_t\mid x_0) =\mathcal N\!\left(x_t;\sqrt{\bar\alpha_t}x_0,(1-\bar\alpha_t)I\right). \]\(\epsilon\) 表示此前所有噪声合并后的标准高斯变量,与单步噪声 \(\epsilon_t\) 区分。这个公式让我们能直接抽取符合第 \(t\) 步分布的 \(x_t\),省去前面各步的模拟,是高效构造训练样本的关键。
2.3 加噪终点
接下来确定生成应从什么分布出发。随着 \(t\) 增加,\(\bar\alpha_t\) 越来越小,原图项逐渐减弱,噪声项逐渐接近标准高斯。只要选择足够长的加噪日程,使 \(\bar\alpha_T\) 很小,就有:
\[ x_T\approx\epsilon\sim\mathcal N(0,I). \]此时,整张图像的联合分布接近各分量独立的标准高斯,生成过程便可以直接从随机噪声出发。
若将原图也视为随机变量,其总体协方差为:
\[ \operatorname{Cov}(x_t) =\bar\alpha_t\operatorname{Cov}(x_0)+(1-\bar\alpha_t)I. \]将系数乘入并合并两个矩阵,得到:
\[ \operatorname{Cov}(x_t)= \begin{bmatrix} \bar\alpha_t\operatorname{Var}(x_0^{(1)})+1-\bar\alpha_t & \bar\alpha_t\operatorname{Cov}(x_0^{(1)},x_0^{(2)}) & \cdots & \bar\alpha_t\operatorname{Cov}(x_0^{(1)},x_0^{(D)})\\ \bar\alpha_t\operatorname{Cov}(x_0^{(2)},x_0^{(1)}) & \bar\alpha_t\operatorname{Var}(x_0^{(2)})+1-\bar\alpha_t & \cdots & \bar\alpha_t\operatorname{Cov}(x_0^{(2)},x_0^{(D)})\\ \vdots & \vdots & \ddots & \vdots\\ \bar\alpha_t\operatorname{Cov}(x_0^{(D)},x_0^{(1)}) & \bar\alpha_t\operatorname{Cov}(x_0^{(D)},x_0^{(2)}) & \cdots & \bar\alpha_t\operatorname{Var}(x_0^{(D)})+1-\bar\alpha_t \end{bmatrix}. \]由前面的加噪公式,对角线上的方差趋近于 \(1\),非对角线上的协方差趋近于 \(0\),即整个矩阵趋近于 \(I\)。
给定某张原图时,条件协方差则只有 \((1-\bar\alpha_t)I\)。前者还包含“原图本身会变化”的不确定性,后者已经把原图固定下来。这个区别在理解反向方差时还会用到。
3. 反向过程
生成的每一步需要确定两件事:前一步的均值在哪里,围绕均值还应保留多少随机波动。下面先给出采样形式,再推导可计算的训练参照,进而确定网络预测什么、采样方差如何选。
3.1 随机采样
即使当前图像 \(x_t\) 已知且固定,前一步 \(x_{t-1}\) 仍有多种可能:不同的前一步可以配合不同噪声,得到同一个 \(x_t\)。反向过程要描述这些可能状态的分布,并从中抽取一个。DDPM 用高斯分布近似真实的反向分布 \(q(x_{t-1}\mid x_t)\):
\[ p_\theta(x_{t-1}\mid x_t) =\mathcal N\!\left(x_{t-1};\mu_\theta(x_t,t),\sigma_t^2I\right), \qquad t>1. \]\(\mu_\theta\) 给出这些可能状态的平均位置,\(\sigma_t\) 描述各分量围绕均值的分散程度。网络输入 \(x_t,t\),输出累计噪声的预测 \(\epsilon_\theta(x_t,t)\),再将它换算成均值:
\[ \boxed{\mu_\theta(x_t,t) =\frac1{\sqrt{\alpha_t}} \left(x_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\epsilon_\theta(x_t,t)\right)}. \]\(1/\sqrt{\alpha_t}\) 撤销前向过程的缩放。这条均值公式将在后面推导;算出均值后,从它附近采样:
\[ x_{t-1}=\mu_\theta(x_t,t)+\sigma_tz, \qquad z\sim\mathcal N(0,I). \]平方误差训练使网络学习可能噪声的条件平均值,因此即使网络学准,算出的也是前一步的均值。\(\sigma_t\) 决定采样的分散程度,随机抽取的 \(z\) 决定这次具体取到哪里;这样得到一个可能的 \(x_{t-1}\),供下一步继续去噪。
下面用全方差公式解释只输出均值会少掉哪些波动。这里考察许多次生成的总体统计:每次输入的 \(x_t\) 都是固定的,不同次生成可以有不同的 \(x_t\)。
全方差公式
总方差由“条件均值之间的方差”和“条件内部方差的平均”组成:
\[\operatorname{Var}(Y)=\operatorname{Var}(\mathbb E[Y\mid X])+\mathbb E[\operatorname{Var}(Y\mid X)].\]证明: 记 \(\mu=\mathbb E[Y]\)。将总偏差拆成“条件均值的偏差”和“条件内部的残差”:
\[Y-\mu=(\mathbb E[Y\mid X]-\mu)+(Y-\mathbb E[Y\mid X]).\]两边平方后取期望:
\[\begin{aligned}\operatorname{Var}(Y)&=\mathbb E[(\mathbb E[Y\mid X]-\mu)^2]+\mathbb E[(Y-\mathbb E[Y\mid X])^2]\\&\quad+2\mathbb E[(\mathbb E[Y\mid X]-\mu)(Y-\mathbb E[Y\mid X])].\end{aligned}\]给定 \(X\) 时,\(\mathbb E[Y\mid X]-\mu\) 已确定,而残差的条件均值为零,因此交叉项消失:
\[\begin{aligned}&\mathbb E[(\mathbb E[Y\mid X]-\mu)(Y-\mathbb E[Y\mid X])]\\&\quad=\mathbb E\!\left[(\mathbb E[Y\mid X]-\mu)\underbrace{\mathbb E[Y-\mathbb E[Y\mid X]\mid X]}_{0}\right]=0.\end{aligned}\]因为 \(\mathbb E[\mathbb E[Y\mid X]]=\mu\),剩下的第一项是条件均值的方差;第二项先按 \(X\) 取条件期望,就是条件方差的平均。于是:
\[\operatorname{Var}(Y)=\operatorname{Var}(\mathbb E[Y\mid X])+\mathbb E[\operatorname{Var}(Y\mid X)].\]可加性来自交叉项为零,不要求这两部分相互独立。
这里以整张 \(x_t\) 为已知信息,只考察前一步的第 \(i\) 个像素通道,即取 \(X=x_t\)、\(Y=x_{t-1}^{(i)}\)。两部分分别是:
- 条件均值之间的方差:不同 \(x_t\) 对应的前一步条件均值之间的方差。网络学准时,近似为 \(\operatorname{Var}(\mu_\theta^{(i)}(x_t,t))\)。
- 条件内部方差的平均:固定一张 \(x_t\),计算可能的前一步像素围绕均值的方差,再对不同 \(x_t\) 取平均。固定的 \(\sigma_t^2\) 用来近似这部分波动。
因此,网络学到正确条件均值时,全方差公式给出:
\[ \operatorname{Var}(\mu_\theta^{(i)}(x_t,t)) \approx\operatorname{Var}(x_{t-1}^{(i)})-\mathbb E_q[\operatorname{Var}(x_{t-1}^{(i)}\mid x_t)]. \]均值只保留平均位置,随机采样再恢复这个位置周围的波动。加入独立噪声后,生成结果 \(y_{t-1}\) 的方差为:
\[ \operatorname{Var}(y_{t-1}^{(i)}) =\operatorname{Var}(\mu_\theta^{(i)}(x_t,t))+\sigma_t^2. \]当 \(\sigma_t^2\) 接近该分量的平均条件方差时,就能补回缺少的波动,使总体方差接近目标。具体数值取决于数据分布,实际模型需要选择或学习这个方差。
3.2 后验分布
要训练反向模型,先需要一个可计算的参照。训练时知道原图 \(x_0\),因此可以求出“已知当前噪声图和原图时,前一步可能是什么”,即后验分布 \(q(x_{t-1}\mid x_t,x_0)\)。生成时没有 \(x_0\),网络则要仅凭 \(x_t\) 给出反向分布。
下面推导 \(t\ge2\) 的情况,先按一维计算,令待求变量为 \(y=x_{t-1}\),将 \(x_t,x_0\) 视为已知。这里写的是标量方差,不带 \(I\);恢复向量形式时,再写成协方差矩阵。
前向过程给出了三个已知分布:单步加噪、累积加噪到 \(t-1\) 步,以及累积加噪到 \(t\) 步:
\[ \begin{aligned} q(x_t\mid y)&=\mathcal N\!\left(x_t;\sqrt{\alpha_t}y,\beta_t\right),\\ q(y\mid x_0)&=\mathcal N\!\left(y;\sqrt{\bar\alpha_{t-1}}x_0,1-\bar\alpha_{t-1}\right),\\ q(x_t\mid x_0)&=\mathcal N\!\left(x_t;\sqrt{\bar\alpha_t}x_0,1-\bar\alpha_t\right). \end{aligned} \]根据贝叶斯公式,并利用马尔可夫性质 \(q(x_t\mid y,x_0)=q(x_t\mid y)\):
\[ q(y\mid x_t,x_0)=\frac{q(x_t\mid y)q(y\mid x_0)}{q(x_t\mid x_0)}. \]分母与 \(y\) 无关,因此只需将分子中的两个高斯密度相乘。第一个因子衡量 \(y\) 能否加噪成当前图像,第二个因子衡量 \(y\) 是否符合原图的加噪规律。
贝叶斯公式与配方
对事件 \(E,F\),贝叶斯公式为:
\[p(E\mid F)=\frac{p(F\mid E)p(E)}{p(F)}.\]固定 \(F\) 后,分母与待求的 \(E\) 无关,可以用 \(\propto\) 省略归一化因子。高斯密度相乘时,指数中的二次式可用配方处理:
\[Ay^2-2By+C=A\left(y-\frac BA\right)^2+C'.\]当密度写成下面的形式时,配方后就能读出均值为 \(B/A\)、方差为 \(1/A\):
\[p(y)\propto\exp\!\left[-\frac12(Ay^2-2By+C)\right].\]一维高斯密度的形式为:
\[ \mathcal N(u;\mu,\sigma^2)=\frac1{\sqrt{2\pi\sigma^2}}\exp\!\left[-\frac{(u-\mu)^2}{2\sigma^2}\right]. \]将两个已知分布的均值、方差代入,省去与 \(y\) 无关的归一化系数:
\[ q(y\mid x_t,x_0)\propto \exp\!\left[-\frac{(x_t-\sqrt{\alpha_t}y)^2}{2\beta_t}\right] \exp\!\left[-\frac{(y-\sqrt{\bar\alpha_{t-1}}x_0)^2}{2(1-\bar\alpha_{t-1})}\right]. \]取对数将乘积变成求和,再乘以 \(-2\),得到:
\[ -2\log q(y\mid x_t,x_0) =\frac{(x_t-\sqrt{\alpha_t}y)^2}{\beta_t} +\frac{(y-\sqrt{\bar\alpha_{t-1}}x_0)^2}{1-\bar\alpha_{t-1}}+C. \]这里 \(C\) 表示与 \(y\) 无关的常数。展开两个平方并收集同类项:
\[ -2\log q(y\mid x_t,x_0)=Ay^2-2By+C, \]其中 \(y^2\) 与 \(-2y\) 的系数分别为:
\[ \begin{aligned} A&=\frac{\alpha_t}{\beta_t}+\frac1{1-\bar\alpha_{t-1}} =\frac{1-\bar\alpha_t}{\beta_t(1-\bar\alpha_{t-1})},\\ B&=\frac{\sqrt{\alpha_t}}{\beta_t}x_t +\frac{\sqrt{\bar\alpha_{t-1}}}{1-\bar\alpha_{t-1}}x_0. \end{aligned} \]上面对 \(A\) 的化简使用了 \(\alpha_t(1-\bar\alpha_{t-1})+\beta_t=1-\bar\alpha_t\)。再将二次式配方,把常数项并入归一化系数:
\[ q(y\mid x_t,x_0)\propto\exp\!\left[-\frac A2\left(y-\frac BA\right)^2\right]. \]与高斯标准形式对照,均值为 \(B/A\),方差为 \(1/A\)。代入 \(A,B\) 并恢复向量记号:
\[ q(x_{t-1}\mid x_t,x_0) =\mathcal N\!\left(x_{t-1};\tilde\mu_t(x_t,x_0),\tilde\beta_tI\right), \]\[ \begin{aligned} \tilde\mu_t(x_t,x_0) &=\frac BA=\frac{\sqrt{\bar\alpha_{t-1}}\beta_t}{1-\bar\alpha_t}x_0+\frac{\sqrt{\alpha_t}(1-\bar\alpha_{t-1})}{1-\bar\alpha_t}x_t,\\[3pt] \tilde\beta_t &=\frac1A=\frac{1-\bar\alpha_{t-1}}{1-\bar\alpha_t}\beta_t. \end{aligned} \]这次推导得到两个量:\(\tilde\mu_t\) 是已知原图时的后验均值,用来指导模型均值 \(\mu_\theta\) 的学习;\(\tilde\beta_t\) 是同一后验的方差,为采样方差 \(\sigma_t^2\) 提供一种选择。它们都能由预设加噪规则算出。\(t=1\) 时已经给定 \(x_0\),后验退化为确定点。
3.3 噪声预测
现在解决“网络具体预测什么”。刚得到的 \(\tilde\mu_t\) 含有原图 \(x_0\),生成时无法直接使用;我们把它改写成噪声的函数,再用网络估计这份噪声。先从累计加噪公式中解出原图:
\[ x_0=\frac{x_t-\sqrt{1-\bar\alpha_t}\,\epsilon}{\sqrt{\bar\alpha_t}}. \]代入后验均值,利用 \(\bar\alpha_t=\alpha_t\bar\alpha_{t-1}\) 合并系数,原图便被累计噪声 \(\epsilon\) 替代:
\[ \tilde\mu_t =\frac1{\sqrt{\alpha_t}} \left(x_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\epsilon\right). \]训练时,\(\epsilon\) 是我们实际抽取的累计噪声,有现成的答案;生成时,用网络预测 \(\epsilon_\theta(x_t,t)\) 代替它,就得到模型均值:
\[ \mu_\theta(x_t,t)=\frac1{\sqrt{\alpha_t}}\left(x_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\epsilon_\theta(x_t,t)\right). \]这一步把“学习反向均值”变成了“学习预测噪声”:\(\tilde\mu_t\) 使用真实累计噪声,\(\mu_\theta\) 使用预测噪声,二者的误差只差一个已知系数。后面的训练损失正是由此得到。
这里的累计噪声 \(\epsilon\) 与单步噪声 \(\epsilon_t\) 用途不同。若知道某一步实际加入的 \(\epsilon_t\),可以精确还原那一步:
\[ x_{t-1}=\frac{x_t-\sqrt{\beta_t}\,\epsilon_t}{\sqrt{\alpha_t}}. \]这条式子还原的是一次具体的加噪记录;生成时并不知道这份 \(\epsilon_t\),所以仍要学习条件分布并采样。
同一份网络输出还可以换算成原图估计:
\[ \hat x_0(x_t,t) =\frac{x_t-\sqrt{1-\bar\alpha_t}\,\epsilon_\theta(x_t,t)}{\sqrt{\bar\alpha_t}}. \]\(\hat x_0\) 估计最终的清晰原图,\(\mu_\theta\) 则用于生成相邻的前一步。原图估计便于观察中途已生成的内容,后面的渐进生成图会用到它。高噪声阶段 \(\bar\alpha_t\) 很小,预测误差被分母放大,因此估计通常较粗糙;随着去噪,结构和细节逐渐清晰。
3.4 方差选择
加噪日程中的 \(\alpha_t,\beta_t\) 预先固定,采样方差 \(\sigma_t^2\) 也可由它们算出。下面按一维推导 \(t>1\) 时的两种选择。
两部分波动。 固定 \(x_t\),按可能的原图分组:每组内部的后验方差都是 \(\tilde\beta_t\),不同组的均值则由下式给出:
\[ \tilde\mu_t(x_t,x_0)=\frac{\sqrt{\bar\alpha_{t-1}}\beta_t}{1-\bar\alpha_t}x_0+\frac{\sqrt{\alpha_t}(1-\bar\alpha_{t-1})}{1-\bar\alpha_t}x_t. \]在固定 \(x_t\) 的条件下应用全方差公式,再代入后验方差和均值:
\[ \begin{aligned} \operatorname{Var}(x_{t-1}\mid x_t) &=\mathbb E[\operatorname{Var}(x_{t-1}\mid x_t,x_0)\mid x_t]+\operatorname{Var}(\mathbb E[x_{t-1}\mid x_t,x_0]\mid x_t)\\ &=\underbrace{\tilde\beta_t}_{\text{类内方差}}+\underbrace{\operatorname{Var}(\tilde\mu_t(x_t,x_0)\mid x_t)}_{\text{类间均值的方差}}\\ &=\tilde\beta_t+\operatorname{Var}\!\left(\frac{\sqrt{\bar\alpha_{t-1}}\beta_t}{1-\bar\alpha_t}x_0\,\middle|\,x_t\right)\\ &=\tilde\beta_t+\frac{\bar\alpha_{t-1}\beta_t^2}{(1-\bar\alpha_t)^2}\operatorname{Var}(x_0\mid x_t). \end{aligned} \]后两步先去掉均值中固定的 \(x_t\) 项,再使用 \(\operatorname{Var}(aX+b)=a^2\operatorname{Var}(X)\)。两部分分别对应同一原图下的波动,以及原图尚未确定带来的均值差异。
采用后验方差。 取类内部分:
\[ \sigma_t^2=\tilde\beta_t=\frac{1-\bar\alpha_{t-1}}{1-\bar\alpha_t}\beta_t. \]原图确定时,\(\operatorname{Var}(x_0\mid x_t)=0\),这就是真实反向方差;一般生成任务采用这个值,相当于省略了类间项。
采用前向方差。 以 \(x_0\sim\mathcal N(0,1)\) 为参照,此时原图的条件方差为:
\[ \operatorname{Var}(x_0\mid x_t)=1-\bar\alpha_t. \]条件方差的计算
已知 \(x_0\sim\mathcal N(0,1)\)、\(x_t\mid x_0\sim\mathcal N(\sqrt{\bar\alpha_t}x_0,1-\bar\alpha_t)\)。由贝叶斯公式,将两个高斯密度相乘,再对 \(x_0\) 配方:
\[\begin{aligned}q(x_0\mid x_t)&\propto\exp\!\left[-\frac12\left(x_0^2+\frac{(x_t-\sqrt{\bar\alpha_t}x_0)^2}{1-\bar\alpha_t}\right)\right]\\&\propto\exp\!\left[-\frac{(x_0-\sqrt{\bar\alpha_t}x_t)^2}{2(1-\bar\alpha_t)}\right].\end{aligned}\]配方后省去只含固定 \(x_t\) 的因子。对照高斯密度,条件均值为 \(\sqrt{\bar\alpha_t}x_t\),条件方差为 \(1-\bar\alpha_t\)。
此时 \(x_0,x_t\) 联合服从高斯分布,两端都是标准高斯,协方差为 \(\sqrt{\bar\alpha_t}\)。交换两者,均值和协方差不变,联合分布也不变,因此前后向条件分布形式相同。同一过程的前后向使用相同的 \(\bar\alpha_t\),才能保留这份关联。
将它代入类间项,两部分之和为:
\[ \begin{aligned} \operatorname{Var}(x_{t-1}\mid x_t) &=\underbrace{\tilde\beta_t}_{\text{类内}}+\underbrace{\frac{\bar\alpha_{t-1}\beta_t^2}{1-\bar\alpha_t}}_{\text{类间}}\\ &=\frac{\beta_t(1-\bar\alpha_{t-1}+\bar\alpha_{t-1}\beta_t)}{1-\bar\alpha_t}=\beta_t. \end{aligned} \]化简使用了 \(1-\beta_t=\alpha_t\) 和 \(\alpha_t\bar\alpha_{t-1}=\bar\alpha_t\)。因此,标准高斯参照下,计入类间波动后的反向方差恰好是 \(\beta_t\),得到第二种设定:
\[ \sigma_t^2=\beta_t=1-\alpha_t. \]对图像向量,两种采样协方差分别为 \(\tilde\beta_tI\) 和 \(\beta_tI\),标准高斯参照相应为 \(\mathcal N(0,I)\)。真实图像生成采用这两种固定近似;加噪后期接近标准高斯,使后一种选择也有实际依据。
两种取值满足 \(\tilde\beta_t<\beta_t\),累计噪声较大时通常接近,在清晰图像附近差别更明显。原始 DDPM 的实验中,两种固定选择得到了相似的生成效果。
4. 训练与生成
4.1 训练步骤
训练使用的主要目标非常直接:构造一张噪声图,让网络预测我们加入的噪声,并最小化两者的平方误差。
\[ L_{\mathrm{simple}}(\theta) =\mathbb E_{t,x_0,\epsilon} \left[\|\epsilon-\epsilon_\theta(x_t,t)\|^2\right]. \]一次更新可以分成四步:
- 从数据集抽取原图 \(x_0\),均匀随机选取 \(t\in\{1,\ldots,T\}\)。
- 抽取 \(\epsilon\sim\mathcal N(0,I)\),直接计算 \(x_t=\sqrt{\bar\alpha_t}x_0+\sqrt{1-\bar\alpha_t}\epsilon\)。
- 将 \(x_t,t\) 输入网络,计算预测噪声与 \(\epsilon\) 的平方误差。
- 通过反向传播求参数梯度,再由优化器更新 \(\theta\)。
其中 \(\|v\|^2=\sum_i v_i^2\),即把各像素通道的误差平方后相加。期望表示对不同原图、步数和噪声取平均;实际训练用一批随机样本估计它,不必每次遍历整条链。随机选步数也让同一个网络不断练习不同难度的去噪任务。
平方误差为什么学到条件均值
固定输入 \(u=(x_t,t)\),令 \(c=\mathbb E[\epsilon\mid u]\)。对任意预测值 \(m\),展开平方可得:
\[\mathbb E[\|\epsilon-m\|^2\mid u]=\mathbb E[\|\epsilon-c\|^2\mid u]+\|c-m\|^2.\]交叉项因 \(\mathbb E[\epsilon-c\mid u]=0\) 而消失。第一项与 \(m\) 无关,因此最优预测为:
\[\epsilon_\theta^*(x_t,t)=\mathbb E[\epsilon\mid x_t,t].\]同一张噪声图可能来自不同的原图与噪声组合,因此平方误差让网络学习这些可能噪声的平均值。
4.2 采样与网络
生成时不再提供原图,也不更新参数。先抽取 \(x_T\sim\mathcal N(0,I)\),再从 \(t=T\) 到 \(1\) 重复:
\[ x_{t-1} =\frac1{\sqrt{\alpha_t}} \left(x_t-\frac{\beta_t}{\sqrt{1-\bar\alpha_t}}\epsilon_\theta(x_t,t)\right)+\sigma_tz. \]当 \(t>1\) 时,每次重新抽取 \(z\sim\mathcal N(0,I)\);最后一步令 \(z=0\),输出均值。反向传播是训练参数的方法,反向扩散是生成样本的过程,两者发生在不同阶段。
噪声预测通常由 U-Net 完成。它先逐渐降低空间分辨率,提取较大范围的结构,再逐渐恢复分辨率;同尺度的前后层通过跳跃连接传递细节。输入与输出的尺寸相同,输出的每个分量对应一个像素通道的噪声预测。
步数 \(t\) 先转换成由不同频率正弦、余弦组成的时间编码,再注入各个残差块,使网络知道当前应处理多强的噪声。所有时间步共用参数,不需要训练 \(T\) 个独立网络。残差连接帮助传递特征和梯度,GroupNorm 调整数值尺度,自注意力则让较远位置的特征相互关联。
一套经典配置是 \(T=1000\),\(\beta_t\) 从 \(10^{-4}\) 线性增加到 \(0.02\),将整数像素从 \([0,255]\) 缩放至 \([-1,1]\)。U-Net 在 \(16\times16\) 的特征分辨率加入自注意力,使用 Adam 优化;评估时使用衰减率 \(0.9999\) 的参数指数移动平均,以减轻训练波动。
5. 训练目标
5.1 变分界
现在回到训练目标的来源。生成模型应当对真实图片赋予较高概率,这对应最大似然,也就是最小化负对数似然 \(\mathbb E_{q(x_0)}[-\log p_\theta(x_0)]\)。整条生成路径的联合分布为:
\[ p_\theta(x_{0:T}) =p(x_T)\prod_{t=1}^{T}p_\theta(x_{t-1}\mid x_t). \]但同一张图片可以经由许多中间路径生成。只计算最终图片的概率时,必须将所有中间状态积分掉:
\[ p_\theta(x_0)=\int p_\theta(x_{0:T})\,\mathrm dx_1\cdots\mathrm dx_T. \]这些中间状态叫作潜变量。单条路径的密度容易算,对所有路径的高维积分却很困难,因此引入容易采样的前向分布 \(q(x_{1:T}\mid x_0)\)。暂将中间路径记为 \(h=x_{1:T}\),有:
\[ \begin{aligned} p_\theta(x_0) &=\int q(h\mid x_0)\frac{p_\theta(x_0,h)}{q(h\mid x_0)}\,\mathrm dh\\ &=\mathbb E_{q(h\mid x_0)} \left[\frac{p_\theta(x_0,h)}{q(h\mid x_0)}\right]. \end{aligned} \]乘除同一个密度不改变结果。取对数并应用 Jensen 不等式,得到证据下界(ELBO):
\[ \log p_\theta(x_0) \geq\mathbb E_{q(h\mid x_0)} \left[\log\frac{p_\theta(x_0,h)}{q(h\mid x_0)}\right]. \]将右边取负,记为 \(L(x_0)\),便得到负对数似然的可计算上界:
\[ -\log p_\theta(x_0) \leq\underbrace{\mathbb E_{q(h\mid x_0)} \left[\log\frac{q(h\mid x_0)}{p_\theta(x_0,h)}\right]}_{L(x_0)}. \]它对对数似然是下界,对负对数似然是上界。训练转而降低 \(L=\mathbb E_{q(x_0)}[L(x_0)]\),不必直接计算难以处理的积分。
Jensen 不等式与 KL 散度
对数是凹函数,所以对正随机变量 \(W\) 有:
\[\mathbb E[\log W]\leq\log\mathbb E[W].\]将 \(W\) 换成上面的密度比,就得到 ELBO。另一个常用量是 KL 散度:
\[D_{\mathrm{KL}}(q\|p)=\mathbb E_{x\sim q}\!\left[\log\frac{q(x)}{p(x)}\right].\]KL 非负,两个分布相同时为零,但一般不对称。由贝叶斯公式还能得到:
\[L(x_0)=-\log p_\theta(x_0)+D_{\mathrm{KL}}\!\left(q(h\mid x_0)\|p_\theta(h\mid x_0)\right).\]上界与真实负对数似然之间的差距,来自两种路径分布的 KL:一种是预设的加噪路径,另一种是生成模型在已知原图时推断出的路径。
5.2 逐步分解
已经得到可优化的似然上界,接下来要把整条路径的目标拆成每一步的任务,从而用到前面推导的后验。给定原图后,根据贝叶斯公式:
\[ q(x_{t-1}\mid x_t,x_0) =\frac{q(x_t\mid x_{t-1})q(x_{t-1}\mid x_0)}{q(x_t\mid x_0)}. \]将这些式子从 \(t=2\) 连乘到 \(T\),累计分布 \(q(x_t\mid x_0)\) 会在分子、分母中逐项约消,只剩首尾项。因此,同一条前向路径可以倒序写成:
\[ q(x_{1:T}\mid x_0) =q(x_T\mid x_0)\prod_{t=2}^{T}q(x_{t-1}\mid x_t,x_0). \]将它与生成路径的乘积分解代入 \(L\),对数将乘积化成求和,再按对应条件分布取期望,便得到:
\[ \begin{aligned} L&=\mathbb E_q\!\left[L_T+\sum_{t=2}^{T}L_{t-1}+L_0\right],\\ L_T&=D_{\mathrm{KL}}\!\left(q(x_T\mid x_0)\|p(x_T)\right),\\ L_{t-1}&=D_{\mathrm{KL}}\!\left(q(x_{t-1}\mid x_t,x_0)\|p_\theta(x_{t-1}\mid x_t)\right),\\ L_0&=-\log p_\theta(x_0\mid x_1). \end{aligned} \]三类项各有作用:\(L_T\) 比较加噪终点与生成起点;\(L_{t-1}\) 比较每步后验与模型反向分布;\(L_0\) 衡量最后一步对原始图片的解释程度。加噪日程固定时,\(L_T\) 是与网络参数无关的常数,参数更新时可以省去。
中间的 KL 使用已知原图的后验作为参照,把整张图片的似然目标拆成了容易计算的逐步去噪任务。
5.3 噪声损失
现在把“让模型接近后验”落实为网络的损失函数。对 \(t\ge2\),后验与模型都是高斯,其 KL 可以直接写出:
\[ L_{t-1} =\frac{\|\tilde\mu_t-\mu_\theta\|^2}{2\sigma_t^2} +\frac D2\left(\frac{\tilde\beta_t}{\sigma_t^2}-1+\log\frac{\sigma_t^2}{\tilde\beta_t}\right). \]第一项衡量均值的差异,第二项衡量方差的差异,两部分共同构成训练损失。若学习方差,方差相关项也需要参与优化;简化噪声损失本身没有方差预测项,需要另有相应的概率目标来训练方差分支。
采用固定方差后,第二项与 \(\theta\) 无关,优化分布差异就等价于优化均值误差。将两个均值的噪声表达式相减:
\[ \tilde\mu_t-\mu_\theta =\frac{\beta_t}{\sqrt{\alpha_t}\sqrt{1-\bar\alpha_t}} \left(\epsilon_\theta(x_t,t)-\epsilon\right). \]平方后代回 KL,可得:
\[ L_{t-1} =\underbrace{\frac{\beta_t^2}{2\sigma_t^2\alpha_t(1-\bar\alpha_t)}}_{w_t} \|\epsilon-\epsilon_\theta(x_t,t)\|^2+C, \]其中 \(C\) 与网络参数无关。这样,固定方差下的高斯分布匹配,就转化成了带权的噪声预测误差。
实际常用的 \(L_{\mathrm{simple}}\) 进一步去掉 \(w_t\),让随机抽到的各个步数使用相同形式的损失。这个改动重新分配了不同噪声程度对训练的贡献:在经典配置下,相对降低小 \(t\)、轻微噪声任务的权重,使训练更关注噪声较大的任务。
若网络容量无限,每个 \(t\) 的正权重不改变该步的最优条件均值;实际中所有步数共用有限的网络,权重会影响网络如何分配能力。简化目标改变了原始变分训练的权衡,并在实验中改善了生成质量。
5.4 离散解码
\(L_0\) 需要单独处理。原始图像的像素是 \(0\) 到 \(255\) 的整数,缩放后的取值为:
\[ x=\frac{2k}{255}-1, \qquad k\in\{0,\ldots,255\}. \]相邻值间隔为 \(2/255\)。连续高斯在某个点的密度不是离散像素的概率,因此将每个像素值对应到一个小区间,再对高斯密度积分:
\[ \begin{aligned} p_\theta(x_0\mid x_1) &=\prod_{i=1}^{D}P_i,\\ P_i&=\int_{\delta_-(x_0^{(i)})}^{\delta_+(x_0^{(i)})} \mathcal N\!\left(u;\mu_\theta^{(i)}(x_1,1),\sigma_1^2\right)\,\mathrm du. \end{aligned} \]普通像素的上下界是 \(x_0^{(i)}\pm1/255\);最小像素把下界延伸到 \(-\infty\),最大像素把上界延伸到 \(+\infty\),以接收高斯尾部的概率。网络根据整张 \(x_1\) 预测各个分量的均值,再把各分量的区间概率相乘,得到整张原图的条件概率。
计算似然时,使用这些区间概率求 \(L_0=-\sum_i\log P_i\)。若高斯密度在像素区间内变化不大,且不是两个边界像素,就可以用“区间宽度乘以密度”近似积分:
\[ L_0\approx\frac{\|x_0-\mu_\theta(x_1,1)\|^2}{2\sigma_1^2}+C. \]在 \(t=1\) 时,\(\bar\alpha_1=\alpha_1\),由加噪式与模型均值式相减可得:
\[ x_0-\mu_\theta(x_1,1) =\sqrt{\frac{\beta_1}{\alpha_1}}\left(\epsilon_\theta(x_1,1)-\epsilon\right). \]将它代回均值误差,便得到:
\[ L_0\approx \frac{\beta_1}{2\sigma_1^2\alpha_1} \|\epsilon-\epsilon_\theta(x_1,1)\|^2+C. \]忽略系数后,最后一步也得到相同形式的噪声损失。至此,所有时间步统一到了 \(L_{\mathrm{simple}}\) 中;与原始 ELBO 相比,它调整了时间步权重,并对最后一步作了近似。
\(\tilde\beta_1=0\) 来自已知原图的退化后验;计算离散像素似然时,解码高斯仍采用正方差。生成算法最后令 \(z=0\),则是直接把预测均值作为输出。
6. 分数匹配
6.1 概率梯度
噪声损失已经给出了可用的训练方法。接下来换一个角度解释它:预测噪声,也是在学习怎样把图像推向概率更高的位置。把第 \(t\) 步所有可能噪声图的边缘密度记为 \(q_t(x_t)\),它的 score(分数函数) 定义为:
\[ s_t(x_t)=\nabla_{x_t}\log q_t(x_t). \]score 是对输入图像求导得到的对数密度梯度。把图像空间中的概率密度想成高低起伏的地形,它就指出当前位置附近密度上升最快的方向。
已知原图时,加噪分布是高斯,对它求导很容易:
\[ \nabla_{x_t}\log q(x_t\mid x_0) =-\frac{x_t-\sqrt{\bar\alpha_t}x_0}{1-\bar\alpha_t} =-\frac{\epsilon}{\sqrt{1-\bar\alpha_t}}. \]网络学到的最优噪声预测是 \(\mathbb E[\epsilon\mid x_t,t]\),恰好可以换算成边缘分布的 score。因此定义:
\[ s_\theta(x_t,t) =-\frac{\epsilon_\theta(x_t,t)}{\sqrt{1-\bar\alpha_t}} \approx\nabla_{x_t}\log q_t(x_t). \]这就是噪声预测与去噪分数匹配的联系:通过一个有已知答案的加噪任务,间接学习未知数据密度的梯度。用 \(s_\theta\) 改写噪声损失,还有:
\[ \|\epsilon-\epsilon_\theta\|^2 =(1-\bar\alpha_t)\left\|s_\theta+\frac{\epsilon}{\sqrt{1-\bar\alpha_t}}\right\|^2. \]因此,相同的噪声平方误差也可理解为不同噪声层级上的加权分数匹配。
条件 score 为什么能学到边缘 score
从边缘化公式出发,在可以交换求导与积分的条件下:
\[q_t(x)=\mathbb E_{x_0\sim q}[q(x\mid x_0)],\]\[\nabla_x\log q_t(x)=\mathbb E_{x_0\sim q(\cdot\mid x)}[\nabla_x\log q(x\mid x_0)].\]第二行使用了 \(\nabla q=q\nabla\log q\) 和贝叶斯公式,即边缘 score 等于条件 score 的后验平均。代入高斯条件 score,便得到:
\[\nabla_{x_t}\log q_t(x_t)=-\frac{\mathbb E[\epsilon\mid x_t,t]}{\sqrt{1-\bar\alpha_t}}.\]6.2 采样联系
将 \(s_\theta\) 代入反向更新式,可以写成:
\[ x_{t-1} =\frac1{\sqrt{\alpha_t}}\left(x_t+\beta_t s_\theta(x_t,t)\right)+\sigma_tz. \]常见的 Langevin 采样则具有如下形式:
\[ x^{k+1}=x^k+\eta\,\nabla_x\log p(x^k)+\sqrt{2\eta}\,z. \]两者都有“沿密度上升方向移动,再加入随机扰动”的结构:梯度引导移动方向,随机项使样本能够在分布中探索。
DDPM 还包含 \(1/\sqrt{\alpha_t}\) 的尺度修正,并让每一步对应不同的 \(q_t\)。它由此形成了与 Langevin 有联系的逐层采样过程,从接近高斯的简单分布逐渐走向复杂的图像分布。
7. 实验结果
生成模型通常从视觉质量与似然两方面评估。FID 比较真实与生成图片的特征分布,越低越好;IS 综合分类器对单张图片的判断是否明确,以及生成结果的类别是否多样,越高越好。
负对数似然通常用 bits/dim 表示,即每个像素分量平均需要的比特数,越低越好。若 \(L\) 用自然对数计算,则 \(L/(D\log 2)\) 给出相应上界。一张 RGB 图片的每个像素有三个分量,因此维数是像素数的三倍。
下面是 CIFAR-10 上两种训练目标的经典结果,用来比较训练选择的影响:
| 训练目标 | IS ↑ | FID ↓ | 测试 NLL 上界 ↓ |
|---|---|---|---|
| 原始变分目标 \(L\) | \(7.67\pm0.13\) | \(13.51\) | \(\leq3.70\) bits/dim |
| 简化目标 \(L_{\mathrm{simple}}\) | \(9.46\pm0.11\) | \(3.17\) | \(\leq3.75\) bits/dim |
表中 FID 以训练集为参照;同一个简化目标模型改用测试集参照时,FID 为 \(5.24\)。因此比较不同报告的数字时,参照集与评估方式也应一致。
简化目标明显改善了生成质量指标,似然上界则略差。直接预测均值与预测噪声在原始变分目标下的效果相近,更显著的改进来自噪声参数化与简化权重的配合。这也体现了视觉质量与似然之间的取舍。
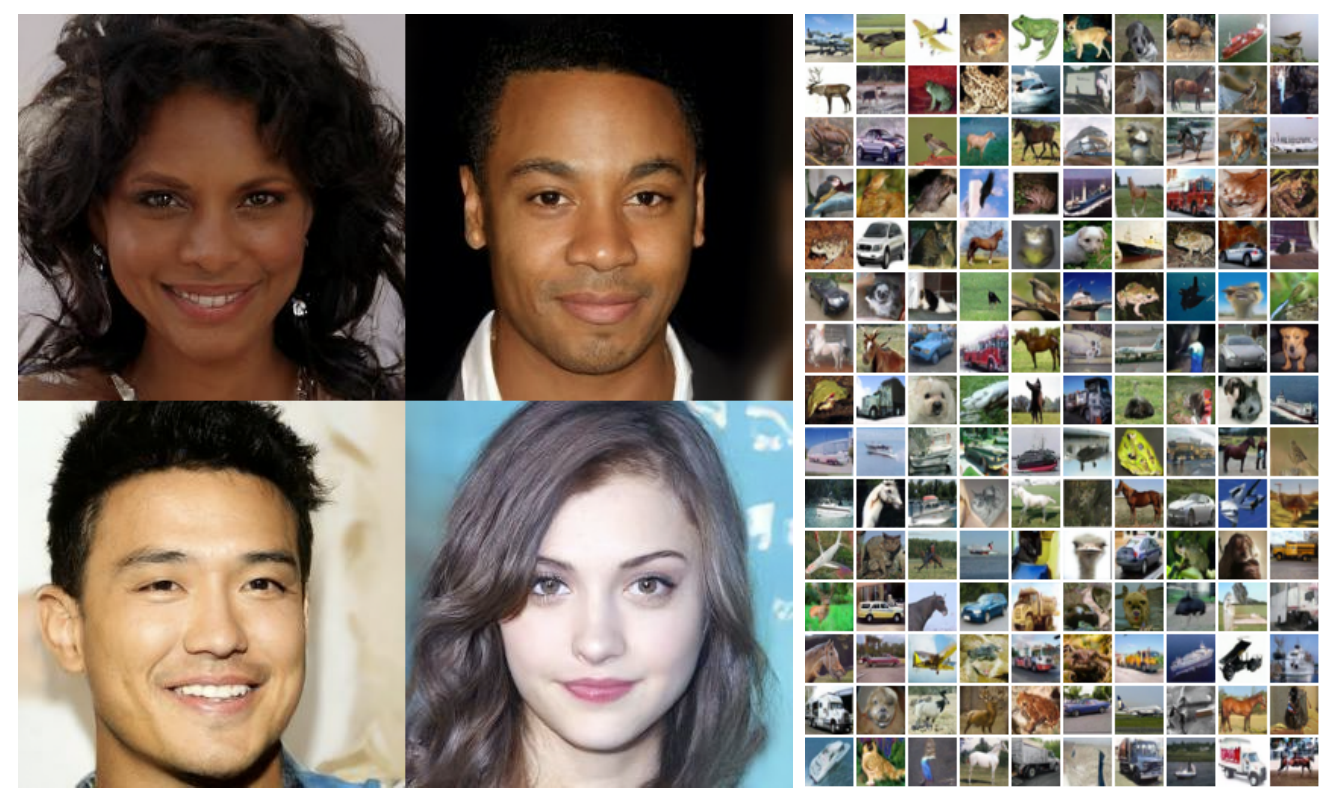
2020 年的较大图像实验还展示了人脸、卧室、教堂等无条件生成结果,例如 LSUN Church 的 FID 为 \(7.89\),较大卧室模型为 \(4.90\)。这些结果确立了扩散模型用于高质量图像生成的潜力。
8. 生成与应用
8.1 渐进生成
生成中途的 \(x_t\) 往往仍有明显噪声,不便直接观察内容。可以在各时刻计算 \(\hat x_0(x_t,t)\),查看模型当前估计的清晰图像。实验中通常先出现轮廓、布局等大结构,再逐渐补足纹理和细节。
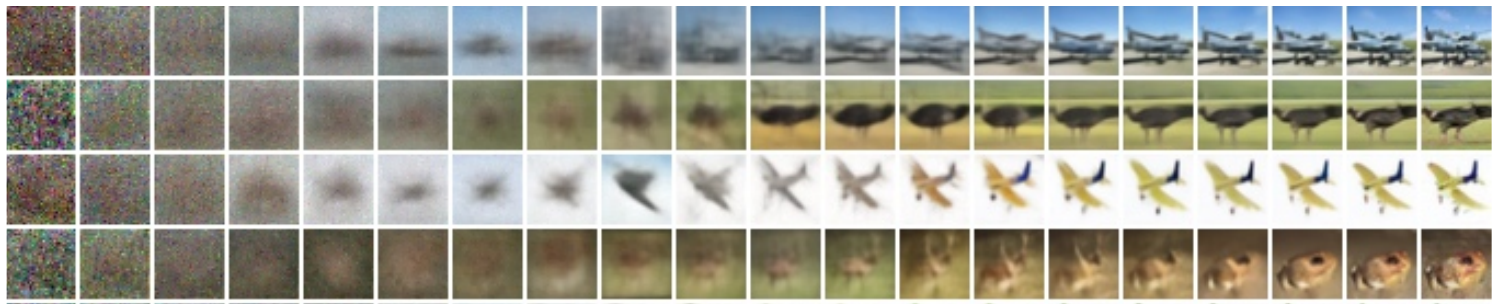
图中展示的是各时刻的原图估计 \(\hat x_0\),可以看到图像从大致轮廓逐渐形成细节。
还可以固定某个中间状态 \(x_t\),从这里重复反向采样。较小 \(t\) 已经保留较多内容,不同结果主要改变细节;较大 \(t\) 留下更多不确定性,结果可以出现明显的内容变化。同一个 \(x_T\) 也能因后续采样不同而产生不同图片。
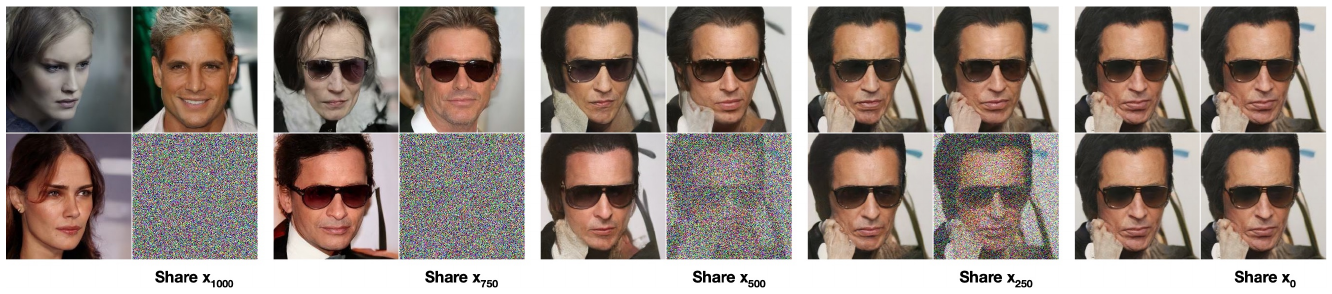
每组右下角是固定的 \(x_t\),其余三格是从它独立反向采样得到的图片。随着 \(t\) 减小,固定状态本身也越来越清晰。
8.2 渐进压缩
加噪逐渐抹去信息,去噪逐渐补回信息,因此扩散链也提供了一种渐进编码的视角。设发送方知道原图,接收方拥有相同生成模型:可以先传递很粗的状态,再逐步传递使图像更接近原图的信息;如果提前停止,接收方就根据已有状态估计图像。
发送方需要把从后验分布抽到的状态告诉接收方。在理想的共享随机性编码方案中,平均码长与后验和模型分布之间的 KL 有关,因此变分目标可以拆成两部分:
\[ \begin{aligned} R&=\mathbb E_q\!\left[L_T+\sum_{t=2}^{T}L_{t-1}\right],\\ D_{\mathrm{rec}}&=\mathbb E_q[L_0],\qquad L=R+D_{\mathrm{rec}}. \end{aligned} \]\(R\) 是传递潜变量的码率,\(D_{\mathrm{rec}}\) 是最后重建的对数损失;两者除以 \(D\log2\) 后,都可以用 bits/dim 表示。
一个代表性模型的两部分分别约为 \(1.78\) 和 \(1.97\) bits/dim,重建图像在 \(0\)–\(255\) 像素尺度上的均方根误差约为 \(0.95\)。这说明无损编码中相当一部分比特用于保存视觉上不明显的细节。这里展示的是压缩原理的概念验证,所依赖的理想编码算法还难以在高维图像上实际执行。
这个视角也能联系自回归模型。若前向过程每步只抹去一个像素分量,反向过程就变成按顺序恢复各个分量,即自回归生成。高斯扩散则同时对所有像素加噪,再随噪声程度降低而逐渐恢复信息。
8.3 图像插值
直接平均两张图片,通常只会得到重影。另一种办法是先将两张图片分别加噪到同一时刻,得到 \(x_t,x'_t\),再混合:
\[ y_t=(1-\lambda)x_t+\lambda x'_t, \qquad 0\leq\lambda\leq1. \]随后从第 \(t\) 步开始反向生成。当 \(\lambda\) 逐渐变化时,模型可以把混合状态重新解释成较自然的图片,从而在两个端点之间形成内容过渡。
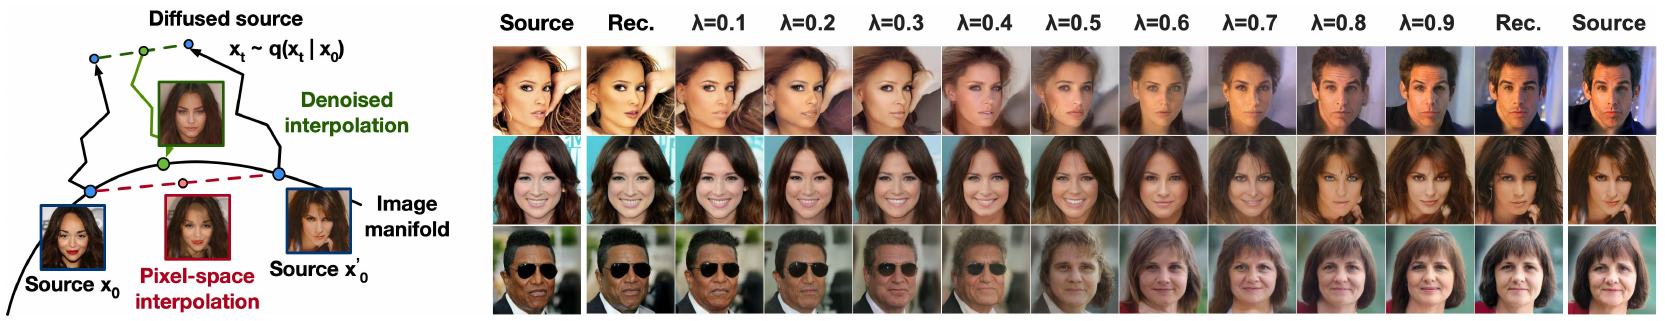
图中使用 \(t=500\);Source 是输入原图,Rec. 是端点重建,中间各列对应不同的 \(\lambda\)。端点的重建也经过了加噪与反向生成。
\(t\) 较小时保留更多原图细节,较大时允许更粗尺度的变化。观察一组 \(\lambda\) 时,固定端点加噪所用的噪声,可以使变化更连贯。最终过渡由模型生成,图像内容的变化通常比像素的线性混合更复杂。
9. 定位与局限
扩散生成的思路可追溯到 2015 年。DDPM 的重要进展,是取得高质量的图像生成效果,并将变分训练、噪声预测、去噪分数匹配和类似 Langevin 的采样联系起来。
从潜变量模型的角度看,DDPM 与 变分自编码器(VAE) 都使用变分界,不过这里直接预设了加噪过程,省去了编码器的学习。归一化流(normalizing flow) 通过可逆变换连接简单分布与数据分布,扩散则采用逐步加噪与随机去噪。前面的 score 推导,又将它与多种噪声程度下的分数模型联系起来。
代价也很明确:经典生成过程约需 \(1000\) 次串行网络调用,采样较慢;简单高斯与固定方差限制了单步分布的表达能力;最好的视觉质量也不对应最好的似然。这里讨论的基本模型主要进行无条件生成,文字控制、少步采样等能力需要进一步的方法。
高质量图像生成可以用于创作,也会带来伪造内容和训练数据偏见的影响。渐进压缩与表征学习则是由这一框架延伸出的研究方向。
参考资料
- Ho, Jain, Abbeel. Denoising Diffusion Probabilistic Models. NeurIPS 2020. arXiv:2006.11239v2。本文实验数据及配图来源,图片保留原有英文标注。
- Sohl-Dickstein et al. Deep Unsupervised Learning using Nonequilibrium Thermodynamics. ICML 2015. arXiv:1503.03585。早期扩散生成模型。
- Vincent. A Connection Between Score Matching and Denoising Autoencoders. Neural Computation, 2011. DOI:10.1162/NECO_a_00142。去噪与分数匹配的联系。
- Song, Ermon. Generative Modeling by Estimating Gradients of the Data Distribution. NeurIPS 2019. arXiv:1907.05600。多噪声层级的分数建模与采样。